

*2026年9月10日 現在でのAIの回答は脅威的に進歩しています。
しかし、AIは最終判定者ではありません。しかし、使い方を決めれば、規格確認の抜け漏れを減らし、検討時間を短縮する有力な補助ツールになります。
2026年版として追加した記事は下記の章です
2026年版 AI・ChatGPTで計数規準型抜取検査のサンプル数を決める方法
抜き取り検査の基礎知識
日本で多く用いられている抜取検査方式としては、以下のものが挙げられます。
-
JIS Z 9015-1(ISO 2859-1)に基づくAQL(合格品質水準)指標型抜取検査:
- 特徴: あらかじめ設定されたAQLに基づいて、ロットの合格・不合格を判定する方式です。生産者と消費者の両方のリスクを考慮した合理的な検査方法であり、国際規格であるISO 2859-1と整合性があるため、広く採用されています。
- 利用場面: 継続的なロットの受け入れ検査や工程内検査など、比較的安定した品質の製品に対して用いられます。
-
JIS Z 9002 に基づく計数規準型一回抜取検査(不良個数の場合):
- 特徴: ロットから一度だけサンプルを抜き取り、その中に含まれる不良品の個数があらかじめ定められた合格判定数以下であればロットを合格とする方式です。
- 利用場面: 比較的単純な製品の検査や、品質が安定していることが期待される場合などに用いられます。
これらの他にも、製品の特性や検査の目的、取引先との合意などに応じて、様々な抜取検査方式が用いられています。例えば、抜き取るサンプルの数を段階的に変える多回抜取検査や、過去の検査結果に基づいて抜き取り数を調整する調整型抜取検査などがあります。
特に、JIS Z 9015-1 に基づくAQL指標型抜取検査は、その合理性と国際的な通用性から、日本国内の多くの産業で広く用いられていると言えます。
JIS Z 9002とJIS Z 9015-1の違い比較表
| 比較項目 | JIS Z 9002 | JIS Z 9015-1 |
|---|
| 規格名 | 計数規準型一回抜取検査 | AQL指標による計数抜取検査方式 |
| 目的 | 抜取検査の統計的設計(基本原則の提供) | AQL基準による実務的な抜取検査の方法提供 |
| 適用範囲 | 計数・計量の統計設計全般 | 計数抜取検査(AQL基準) |
| 抜取方式の種類 | 単回・二回・多回・連続抜取検査 | 単回・二回・多回(MIL-STD-105系) |
| 主な指標 | p₀, p₁, α, β(OC曲線による設計) | AQL(合格品質限界) |
| 抜取数と合格判定数の決め方 | 統計設計に基づいて計算で決定 | コードレターとAQLから表で決定 |
| 表の使用可否 | ×(AQL表は使用しない) | 〇(AQL表を使用) |
| 実務での使用頻度 | 中(設計や制度構築向け) | 高(現場・納入検査・契約検査) |
| 代表的な用途 | 新製品の信頼性設計、品質保証契約など | ロット検査、納入品検査、工程抜取検査など |
*抜き取り検査の詳細は下記の記事を参照願いします。

ChatGPTで計数規準型 JIS Z 9002のサンプル数を求める
計数規準型抜取検査 JIS Z 9002に基づく抜取検査とは?
計数規準型抜取検査は,売り手に対する保護と買い手に対する保護の二つを規定して,売り手の要求と買い手の要求との両方を満足するように組み立てられた抜取検査である。
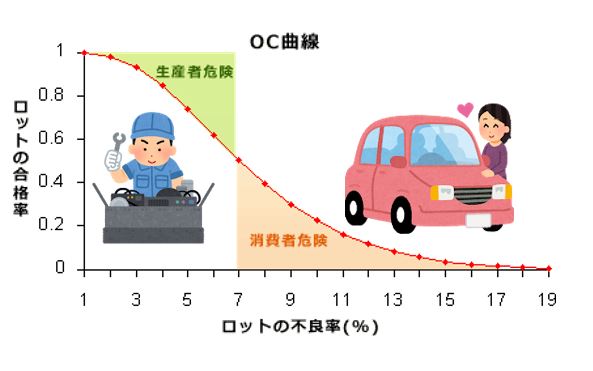
売り手に対する保護とは,不良率p0%のような品質の良いロットが,抜取検査で不合格となる確率α(生産者危険)を一定の小さな値に決めていることであり,買い手に対する保護とは,不良率p1%のような品質の悪いロットが合格となる確率β(消費者危険)を一定の小さい値に決めていることである。
一般には,α= 0.05,β=0.10と決めている。
このことは,合格とさせたいロットの不良率p0%と,そのときに不合格となる割合αならびに不合格とさせたいロットの不良率p1とそのときに合格となる割合βを決めることであり,この2組の値が与えられているときは,次の連立方程式を解いて,サンプルの大きさnと合格判定個数Cを求めることである。
合格としたいロットの合格となる割合は
$$L(p0)=1-α=\sum_{x=0}^{c}{ n \choose x } p0x(1-p0)n-x$$不合格としたいロットの合格となる割合は
$$L(p1)=β=\sum_{x=0}^{c}{ n \choose x } p1x(1-p1)n-x$$
以前は上記計算式を現場で計算する手間を省くために実際に抜取方式(n, c)を設計する場合には,既に上式からサンプルの大きさnと合格判定個数Cが計算されているJIS Z 9002 (計数規準型一回抜取検査) で表で求めていた。
JIS Z 9002でサンプル数を求める! 計算式と付表の違いは?
「JIS Z 9002(計数規準型一回抜取検査)」における (n, c)の求め方における「計算式」と「付表(表による方式)」の違い は、以下のようになります。
「付表(表による方式)」とは
JIS Z 9002の付表(JIS Z 9002の付属書Aや付表1など)には、あらかじめ設定された条件(例えば:p₀, p₁, α, β)に基づいて決定されたサンプル数nと合格判定数cが一覧で記載されています。
特徴:
-
即座に使える:表から条件に対応する(n, c)を探せばすぐ使える。
-
典型的な条件に限定される:p₀=2%、p₁=12%、α=0.05、β=0.10 などの「代表的な設定」しか記載されていない。
-
業務での実用性が高い:品質管理の現場では、これらの代表的な(n, c)をそのまま運用することが多い。
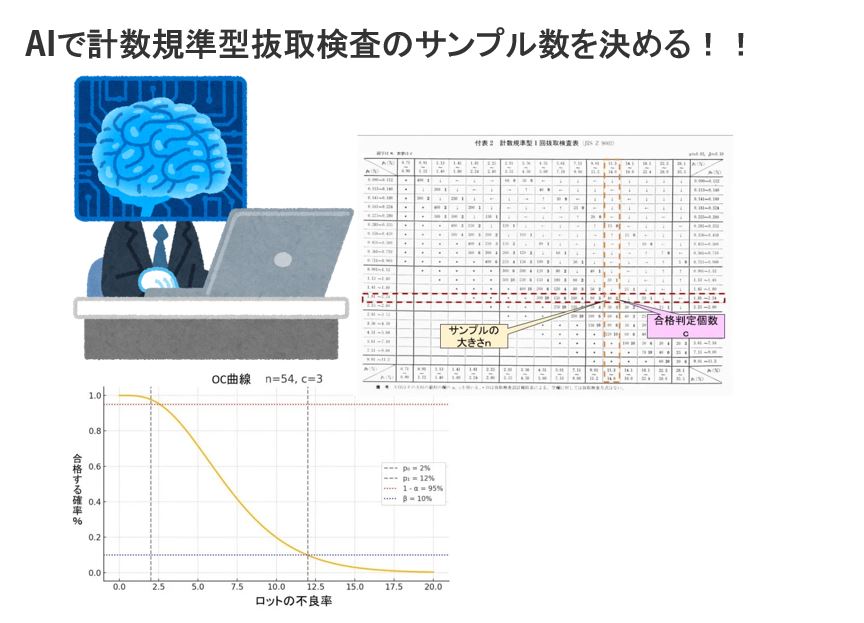
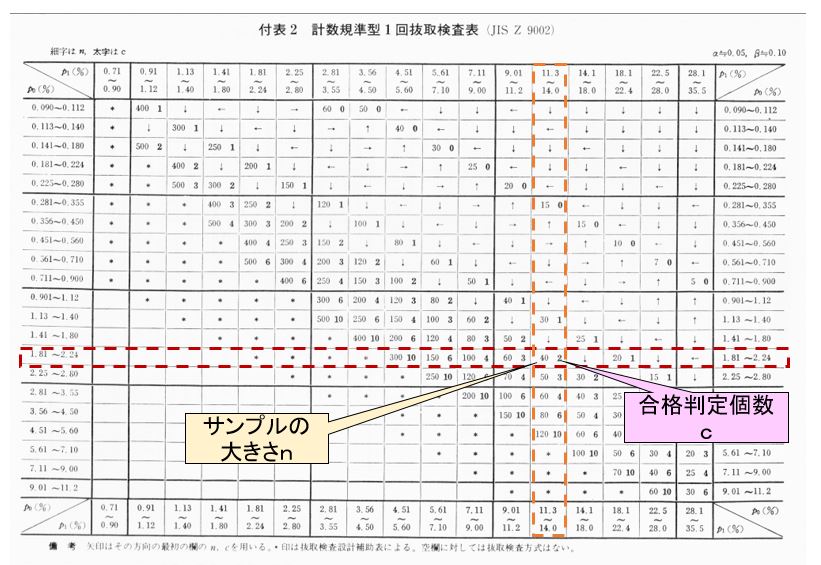
下記の表の欄中の左側の数値(細字)40がサンプルの大きさであり,右側の数値(太字)2が合格判定個数cである。
「計算式による方式」とは
付表に載っていないようなp₀, p₁, α, βなどの任意の値に対応した**最適な(n, c)**を求めたい場合に使われるのが計算式(OC曲線を用いた計算)です。
基本概念:
計数規準型の抜取検査は、二項分布または正規近似に基づいて、
-
生産者危険(α)以下でロットが不合格になる確率
-
消費者危険(β)以下でロットが合格になる確率
という条件を満たす(n, c)を求めます。
計算式の考え方(簡略):
二項分布または正規分布近似を用いて:
-
この式で、p=p₀のとき:P(合格) ≥ 1 − α
-
p=p₁のとき:P(合格) ≤ β
これを満たす最小のnとそれに対応するcを試行的に探します(ソルバなど使用)。
違いのまとめ表
| 比較項目 | 付表方式 | 計算式方式(OC曲線方式) |
|---|---|---|
| 使用条件 | 標準設定のみ | 任意のp₀, p₁, α, βに対応 |
| 精度 | あらかじめ調整された信頼性 | 精密だが数値解法が必要 |
| 手軽さ | すぐに使える | Excelやプログラムで計算が必要 |
| 主な用途 | 実務、標準検査 | 研究、特殊条件での検査設計 |
| 計算必要性 | 不要(表を見るだけ) | 必要(逐次的に(n, c)を評価) |
-
以前は通常の品質管理業務 → 付表方式が実用的で十分
-
より厳密またはカスタム設計したい場合 → **計算式方式(OC曲線)**を使用
*AIが進化した現在、計算式方式(OC曲線)の方が正確で速い!
ChatGPTで計数規準型 JIS Z 9002のサンプル数を求める方法
ChatGPTで JIS Z 9002 計数規準型抜取検査 のサンプル数
と合格判定数
を求めるには、以下の手順に従って進めます。JIS Z 9002は「OC曲線(合格率曲線)」を前提とした検査方式なので、ChatGPTを使って計算を再現できます。
JIS Z 9002 の基本パラメータ
まず、次の4つの条件を定めます:
| 記号 | 内容 | 例 |
|---|---|---|
| 良いロットと考える不良率(合格させたい) | 2%(0.02) | |
| 悪いロットと考える不良率(不合格にしたい) | 12%(0.12) | |
| 生産者危険(良品を不合格にする確率) | 5%(0.05) | |
| 消費者危険(不良品を合格にする確率) | 10%(0.10) |
ChatGPTに指示する方法(プロンプト)
たとえば、次のように指示してください:
JIS Z 9002に基づく計数規準型抜取検査を行いたいです。
条件は以下の通りです:
(良品)
(不良品)
、
上記条件に基づき、ChatGPTで(n, c)を満たす最小の組を求めてください。
近似式(二項分布または正規分布)を使ってください。
ChatGPTの回答
ご指定の条件に対して、二項分布による正確な計算を行った結果、以下のような検査計画(n, c)が最小で条件を満たしました:
最適な抜取検査計画(JIS Z 9002 準拠)
| 項目 | 値 |
|---|---|
| サンプル数 |
54合格判定数
3
97.7%(≧ 95%:OK)
9.83%(≦ 10%:OK)
解釈:
-
不良率が 2%(良品) のロットは 97.7% の確率で合格 → 生産者危険 α=5% を満たす。
-
不良率が 12%(不良品) のロットは 9.8% の確率で合格 → 消費者危険 β=10% を満たす。
「54個抜取り、不良が3個以下なら合格、4個以上で不合格」
という検査方式が、JIS Z 9002の計数規準型一回抜取検査において、指定のリスク条件を最も小さいnで満たします。
下のグラフが、n = 54、c = 3 の抜取検査における OC曲線(合格確率 vs 不良率) です。

読み取りポイント:
- 縦軸(Y):ロットが「合格」と判定される確率
- 横軸(X):ロットの実際の不良率(%)
- p₀ = 2%(左の点線):
- この水準では**97.7%**の確率でロットは合格 → α ≒ 5%以下(OK)
- p₁ = 12%(右の点線):
- この水準では**約9.8%**しか合格しない → β ≒ 10%以下(OK)
比較 Geminiで計数規準型 JIS Z 9002のサンプル数を求める
JIS Z 9002に基づく計数規準型抜取検査を行いたいです。
条件は以下の通りです:
(良品)
(不良品)
、
近似式(二項分布または正規分布)を使ってください。
Geminiの回答
上記の探索の結果、与えられた条件を満たす最小の組 は (65, 3) であると考えられます。
この抜取計画では、65個のサンプルを抜き取り、その中に不良品が3個以下であればロットを合格、4個以上であれば不合格とします。これにより、生産者リスクは0.05以下、消費者リスクは0.10以下に抑えられます。
注意点
- 上記の計算は二項分布に基づいて行っています。
- 最小の組 を厳密に求めるには、より系統的な探索アルゴリズムが必要となる場合があります。
- 実際のJIS Z 9002の規格票には、抜取検査表が掲載されており、これらの表を参照することで適切な抜取計画を容易に選択できます。今回の計算は、規格票の背後にある原理を示すものです。
ChatGPTとGeminiの回答が何故違う?
なぜChatGPTの結果(n=54, c=3)とGeminiの結果(n=65, c=3)が異なるのか? について、
ChatGPTに質問した結果です。
結論から言うと:
GeminiとChatGPTの前提条件または計算手法がわずかに異なるために結果が異なっています。
詳細な理由と可能性
① 判定条件(αとβの境界)に対する「厳密さ」
-
ChatGPTでは
P(p₀) ≥ 1 - α = 0.95かつP(p₁) ≤ β = 0.10を厳密に満たす最小のnを探しています。 -
Geminiのロジックでは、やや保守的な計算(例えば、「両側信頼区間を確保」や「より広めのnを選ぶ」)を行っている可能性があります。
たとえば、n=54では生産者危険には余裕がありますが、消費者危険は約9.83%で10%の上限に近い値です。
② 数値計算の手法の違い
-
ChatGPTでは 二項分布の累積確率(
binom.cdf)を直接計算して条件を正確に判定しています。 -
一方、Geminiは正規分布近似や計算簡略化手法を使っている可能性があり、その結果としてわずかに大きなnが出ることがあります。
③ 小数点以下の丸め・安全係数の取り扱い
-
ChatGPTは「最小のnを探索し、ギリギリ合格ラインを満たすcを選ぶ」という方針。
-
Geminiは「より安全側(余裕あり)」に振っているか、表準拠で安全率込みの数値(例えばJISの付表ベース)を出しているかもしれません。
表
| 項目 | ChatGPT | Gemini |
|---|---|---|
| サンプル数 (n) | 54 | 65 |
| 合格数 (c) | 3 | 3 |
| 方針 | 厳密条件で最小探索 | 保守的、安全寄り |
| 現場での採用性 | 最小で済む | 安全率高めで安心 |
どちらが正しいのか?
-
ChatGPTの結果(n=54, c=3)は指定されたα, β, p₀, p₁に厳密に合う最小構成です。
生産者危険:約2.29%(5%以下:OK)
消費者危険:約9.83%(10%以下:OK)
-
Geminiの結果(n=65, c=3)は安全側に寄せた運用向きの結果であり、企業実務ではこちらを採用する場合もあります、両方のリスクを許容限界内に収めています。
*どちらを採用しても実用上、問題ないレベルと判断させます。
まとめ
2022年末に生成AIChatGPT が登場し、大衆向け生成AIブームが始まってから約2年もたたないのにAIの進歩は凄まじい。
2025年5月6日 現時点ではAI ChatGPT及びGeminiの回答は不正解だったが再学習して近い将来は100%正解に近づくと予想される。
後、数年で抜き取り検査のサンプル数、合格判定個数を調べたい場合、AIに的確な条件のプロント文を指示せれば正しい回答が得られる時代が間もなく到来する。
しかし、その時でもやはり 人の評価、レビューが必要であり『抜き取り検査の基本知識』を学んで身につけなければならない!
*抜き取り検査の詳細は下記の記事を参照願いします。
*上記の記事は2025年5月6日に作成した内容です。
*下記は2026年9月9日でのAIの回答を纏めた内容です、かなり回答が違っています。
2026年版 AI・ChatGPTで計数規準型抜取検査のサンプル数を決める方法 |JIS Z 9002 をGMO天秤AIで検証
ChatGPTに使う改善版プロンプト
ChatGPTに計数規準型抜取検査のサンプル数を求めさせる場合、単に「サンプル数を計算して」と指示するだけでは、計算方法や条件の解釈によって異なる回答が出ることがあります。
特に、JIS Z 9002を意識して検討する場合は、次の条件を明確に指定することが重要です。
・良いロットの不良率 p0
・悪いロットの不良率 p1
・生産者危険 α
・消費者危険 β
・二項分布を使うこと
・最小のサンプル数 n を探索すること
・合格判定個数 c も同時に求めること
・求めた結果を再計算して検証すること
改善版プロンプト例
以下のプロンプトをコピーして利用できます。
JIS Z 9002の考え方を参考に、計数規準型一回抜取検査の抜取方式を検討してください。
条件は以下です。
良いロットの不良率 p0=0.02
悪いロットの不良率 p1=0.12
生産者危険 α=0.05
消費者危険 β=0.10
不良個数は二項分布に従うものとして計算してください。
サンプル数を n、合格判定個数を c とし、
p=p0 のとき
P(不良個数≦c)≧1-α
かつ
p=p1 のとき
P(不良個数≦c)≦β
を同時に満たす整数の組(n、c)を探索してください。
n=1から順番に全探索し、条件を満たす最小のnを求めてください。
さらに、求めた(n、c)について、次の内容を再計算して示してください。
- p0での合格確率
- 生産者危険 α
- p1での合格確率
- 消費者危険 β
- 判定ルール
- 一つ前のnでは条件を満たさないこと
最後に、計算式と検証結果を表形式でまとめてください。
なお、JIS規格そのものを再現したと断定せず、二項分布による計算結果として説明してください。
プロンプトを改善するポイント
ChatGPTへの指示では、「答えだけ」を求めないことが重要です。
特に、
・計算根拠を表示してください
・条件を満たすか再計算してください
・最小nであることを確認してください
と追加することで、回答の検証性が高くなります。
品質管理でAIを使用する場合は、
「答えを出させるプロンプト」ではなく、「答えを検証させるプロンプト」
にすることがポイントです。
JIS Z 9002をChatGPTで扱う場合の注意点
ChatGPTはJIS Z 9002を理解するための補助ツールとして便利ですが、使用するときには注意が必要です。
最も重要なのは、
「ChatGPTはJIS規格そのものではない」
ということです。
AIが表示したサンプル数や合格判定個数を、そのまま「JIS Z 9002で定められた値」と扱うのは避ける必要があります。
JIS規格とAI計算を区別する
JIS Z 9002は、計数規準型一回抜取検査について定めた規格です。
一方、ChatGPTで二項分布を計算して得られたn、cは、
「設定したp0、p1、α、βに対する統計計算結果」
です。
計算結果がJISの考え方と整合していても、
「ChatGPTで計算したからJIS準拠」
とは限りません。
実際の品質保証業務では、正式な規格票を確認することが必要です。
AIは規格の版や適用条件を取り違える可能性がある
生成AIは、次のような規格や考え方を混同することがあります。
・JIS Z 9002
・JIS Z 9015-1
・ISO 2859-1
・AQL方式
例えば、JIS Z 9002の質問をしているのに、AQLや検査水準、ロットサイズを使ってJIS Z 9015-1の方法で回答する場合があります。
そのため、最初に、
「JIS Z 9002の計数規準型一回抜取検査として考えてください」
と明示することが重要です。
p0とp1の意味を取り違えない
p0は「良いロット側」の不良率、
p1は「悪いロット側」の不良率です。
通常は、
p0 < p1
となります。
この関係が逆になっていないか、必ず確認します。
αとβを取り違えない
AI回答で特に注意したいのが、生産者危険と消費者危険です。
生産者危険 α:
良いロットを誤って不合格にする確率
消費者危険 β:
悪いロットを誤って合格にする確率
です。
したがって、
p=p0では合格確率が高く、
p=p1では合格確率が低くなる
必要があります。
AIで抜取数を決めるときの安全な手順
AIを使って抜取数を検討する場合は、次の手順で進めると安全です。
手順1 適用する検査方式を決める
最初に、次のどの検査方式を使うのか確認します。
・JIS Z 9002
・JIS Z 9015-1
・社内独自基準
・顧客指定の検査基準
ここが曖昧なままAIへ質問すると、違う抜取方式が提示される可能性があります。
手順2 品質条件を設定する
次に、
p0
p1
α
β
を設定します。
例えば、
p0=2%
p1=12%
α=5%
β=10%
とします。
これらの値は、単にAIに決めさせるのではなく、
・顧客要求
・製品リスク
・過去の不良率
・工程能力
・検査コスト
などを考慮して人が決定することが重要です。
手順3 AIに候補を計算させる
条件を設定したらChatGPTへ入力し、nとcの候補を求めます。
このとき、
・二項分布で計算
・nの小さい順に探索
・最小nを求める
と指定します。
手順4 p0側を確認する
求めたn、cについて、p0での合格確率を計算します。
そして、
P(合格|p0)≧1-α
を確認します。
満たしていなければ、その抜取方式は採用できません。
手順5 p1側を確認する
次に、
P(合格|p1)≦β
を確認します。
この条件を満たしていない場合、悪いロットを合格させる可能性が高くなります。
手順6 最小nを確認する
例えばAIが、
n=54、c=3
と回答した場合、
n=53では本当に条件を満たさないか
を確認します。
AIは条件を満たす値を見つけても、「最小値」の探索を完全に行っていない場合があります。
手順7 別の方法でも確認する
重要な検査方式については、
・Excel
・Python
・統計ソフト
・正式なJIS規格票
などでも確認します。
AIだけで最終決定しないことが重要です。
手順8 現場条件を確認する
統計的に適切でも、実際の現場で使いやすいとは限りません。
例えば、
・検査時間
・検査員数
・破壊検査か非破壊検査か
・検査費用
・測定機器の能力
・不良流出時の影響
なども考慮します。
つまり、
「統計的に正しい抜取数=現場で最適な抜取数」
とは限りません。
現場で使えるAI回答チェックリスト
ChatGPTなどの生成AIで抜取検査方式を求めた場合は、次のチェックリストを使うと便利です。
基本条件
□ 使用するJIS規格が明確になっている
□ JIS Z 9002とJIS Z 9015-1を混同していない
□ p0<p1になっている
□ αの意味が「良いロットを不合格にする確率」になっている
□ βの意味が「悪いロットを合格にする確率」になっている
計算条件
□ 二項分布を使用している
□ サンプル数nが整数になっている
□ 合格判定個数cが整数になっている
□ p0での合格確率を計算している
□ p1での合格確率を計算している
□ P(合格|p0)≧1-αを満たしている
□ P(合格|p1)≦βを満たしている
最小サンプル数の確認
□ 「最小n」と指定している
□ n-1で条件を満たさないことを確認している
□ 他のcについても確認している
実務適用
□ JIS規格票と照合している
□ 顧客要求仕様を確認している
□ 社内品質基準を確認している
□ 検査コストを確認している
□ 破壊検査の場合はサンプル数増加の影響を確認している
□ 重大不良では抜取検査自体が適切か検討している
□ AI回答を人が最終確認している
このチェックリストで特に重要なのは、
「数値が出たか」ではなく「数値を検証したか」
という点です。
GMO天秤AIでJIS Z 9002を検証
去年指示したchatGPTの下記のプロント文をGMO天秤AIに指示しました。
JIS Z 9002に基づく計数規準型抜取検査を行いたいです。
条件は以下の通りです:
(良品)
(不良品)
、
上記条件に基づき、ChatGPTで(n, c)を満たす最小の組を求めてください。
近似式(二項分布または正規分布)を使ってください。
GMO天秤AIの回答
1. 統合結論(メタ評価を踏まえた最適解の提示)
統合結論(最終アウトプット)
二項分布を前提に、標本中の不適合品数を
、不適合品数が
以下ならロット合格とすると、条件は
です。
小さい合格判定個数から確認すると、
では両条件を同時に満たす
がありません。特に
では、
- 生産者危険側:おおむね
- 消費者危険側:
となり、範囲が重なりません。
では、
に対して、
となります。また、
です。したがって、二項分布による厳密探索で抜取数
を最小化した結果は、
です。
運用上は、54個を抜き取り、不適合品が0~3個なら合格、4個以上なら不合格とします。実際の生産者危険は約2.29%、消費者危険は約9.83%です。
なお、
は「良品率」ではなく、通常は良いロットの基準となる不適合品率と表現します。また、JIS Z 9002の附表・丸め規則をそのまま適用することが契約・社内規程上必要なら、表から
などが選ばれる可能性があるため、数学的な最小解と規格表による採用値は区別してください。
▶︎ アクションへの接続:独立な二項モデルで最小抜取数を求めるなら
を採用し、正式なJIS適合が必要なら使用版の附表・丸め規則と照合してください。
2. 全体サマリー(1〜3行)
- 5回答中3回答が、二項分布に基づく最小解を
としており、これが最も根拠の強い結論です。
- Perplexityの
は生産者危険側を満たさず誤り、Plamoの
は条件を満たす可能性は高いものの最小解ではなく、根拠も示されていません。
3. 共通点とコンセンサス
- すべての回答が、抜取数
と合格判定個数
を決める問題として扱っています。
- 多くの回答が、合格確率を
で評価する計数一回抜取方式を前提としています。 - Anthropic、OpenAI、XAIの3回答は、次の点で一致しています。
では両条件を同時に満たせない
では
が不成立、
が成立
- 二項分布による最小解は
- Plamoの
も、
と同じ「
付近」という多数派の方向性には属します。
明確なコンセンサスと呼べるのは、「
近辺が妥当」という点です。
ただし、全AIが同じ最小解に合意しているわけではありません。
4. 相違点・分岐パターンの整理
A. 二項分布による最小解
を支持
- AnthropicClaude5Sonnet
- OpenAIgpt56Sol
- XAIGrok46
いずれも
と54の境界を確認し、54を最小としています。結論として最も信頼できるグループです。
B. 規格表・丸めを意識した保守的な値
- Plamo30Prime:
- Anthropicも参考情報として55や60の可能性に言及
は要求条件を満たす側の値ですが、「二項分布上の最小解」ではありません。規格附表の採用値であるなら意味がありますが、その説明が必要です。
C.
を採用する少数派
- PerplexitySonar:
これは他回答との単なる方針差ではなく、二項分布の条件に反します。
の合格確率は95%未満となるため、生産者危険の条件を満たしません。
D. アプローチの違い
- Anthropic:正規近似から入り、二項分布で精査
- OpenAI:小さい
から体系的に探索
- XAI:境界値を簡潔に検証
- Perplexity:外部資料を多数掲示するが、数値検証が不足
- Plamo:結論のみ
5. 各回答のメタ評価
AnthropicClaude5Sonnet:説明の流れに強み。細部の数値精度に弱さ
強み
- 正規近似を概算と位置づけ、二項分布による精査が必要と説明しています。
が不成立、
が成立する構造を示しています。
- JIS附表と数学的最小解がずれる可能性に触れた点は実務的です。
弱み
を「良品率」と表記しているのは不正確で、不適合品率の基準です。
の消費者危険側を「
」としていますが、実際の境界は
です。
の値も約0.9771であり、0.9775はわずかにずれています。
- 「JISで55や60」の根拠が具体的ではありません。
ユニークなポイント
- 近似解と厳密解を分けた説明は、計算過程を理解するうえで有用です。
OpenAIgpt56Sol:最も体系的で、実務転用しやすい
強み
- 二項分布の式を明示し、小さい
から探索する方法が明快です。
の成立範囲を表にしており、なぜ
が選ばれるか追跡できます。
- 生産者危険・消費者危険の実際値を区別しています。
- 合格条件と不合格判定個数
まで示し、運用に接続しています。
弱み
- 「JIS Z 9002の附表による正式な選定」と「二項分布の直接探索」の違いには触れていません。
- 有限ロットの場合の超幾何分布という前提差も扱っていません。
ユニークなポイント
からの探索表により、最小性を最も分かりやすく裏付けています。
PerplexitySonar:情報源提示は豊富だが、中心計算が誤っている
強み
- JISや抜取検査に関する資料を広く提示しています。
- 再現コードや探索手順を提案しており、追加調査への導線はあります。
弱み
- 結論の
は二項分布の条件を満たしません。
- 「合格確率が95%以上」と断言しながら、実際の確率を計算・提示していません。
- 多数の出典がありますが、個々の出典が
を直接裏付けているか不明です。
- 「近似式で求めた最小」と「厳密な最小」を混同しています。
ユニークなポイント
- 外部資料探索の入口としては使えますが、数値結論の根拠としては採用できません。
Plamo30Prime:簡潔だが、判断根拠が不足
強み
- 非常に簡潔です。
は最小ではないものの、要求を満たす保守的な候補と考えられます。
弱み
- 計算式、確率、JIS附表の参照などが一切なく、検証できません。
- なぜ54ではなく55なのか説明がありません。
- 「最小解」を問う文脈では不十分です。
ユニークなポイント
- もし特定のJIS附表から直接得た値なら有用ですが、回答本文からは判別できません。
XAIGrok46:簡潔さと境界検証のバランスが良い
強み
と
の境界値を直接比較し、最小性を効率的に示しています。
と54の差を数値で説明しています。
では必要な
が増えることにも触れ、全体最小である理由を補っています。
弱み
- 二項累積確率の式自体は明示していません。
- JIS附表による選定との違いや有限ロットの前提には触れていません。
の説明は妥当ですが、具体的な境界表まではありません。
ユニークなポイント
- 短いながら、最小性に必要な論点をほぼ押さえています。
6. 抜けている視点・盲点(Gaps)
- 「二項分布の最小解」と「JIS附表による規格上の採用値」の区別
- 多数派の計算は二項分布による直接探索です。
- 正式な規格適合が目的なら、JISの版、附表、丸め・標準化された抜取数の扱いを確認する必要があります。
- 有限ロットサイズの影響
- 各回答は事実上、無限母集団または復元抽出に相当する二項分布を仮定しています。
- ロットサイズ
が小さく、非復元抽出なら超幾何分布による再計算が必要です。
- 最小性の定義
- 今回は「抜取数
の全体最小」と解釈されています。
- コスト、検査破壊性、合格判定個数の運用容易性など別の最適化基準がある場合、採用案は変わり得ます。
- 今回は「抜取数
- 用語の精度
は「良品率2%」ではなく、「良いロットとして扱う不適合品率2%」です。
- この誤記は実務文書では重大な誤解につながります。
- 再現可能性
- 多数派でも、Excel・Python・統計ソフトでの計算方法は示されていません。
- 規程化するなら、使用関数・丸め桁・探索範囲を記録するのが望まれます。
7. 意思決定のための“判断ポイント”整理
| 判断軸 | 適した回答・組み合わせ | 評価 |
|---|---|---|
| 二項分布による最小解を重視 | OpenAI+XAI |
の根拠が明確 |
| 計算過程を学習したい | OpenAI+Anthropic | 探索表と近似から厳密計算への流れを補完 |
| 短く要点だけ確認したい | XAI | 簡潔ながら境界値を検証 |
| JIS附表との違いも意識したい | Anthropicを補助的に利用 | 注意喚起は有用だが、附表での再確認が必要 |
| 保守的な抜取数を採用したい | Plamoの55を候補にしつつ別途検証 | 成立は見込めるが、最小ではなく根拠不足 |
| 外部資料を調べたい | Perplexityのリンクのみ参考利用 | 数値結論
は採用不可 |
判断の優先順位としては、次の整理が適切です。
- 数学的最小性を優先:
- 社内・契約上のJIS表準拠を優先:該当版の附表で54、55などの採用値を確認
- 安全側に丸めたい:
も候補だが、追加1個の合理性を明文化
- 有限ロット:ロットサイズを入れて超幾何分布で再設計
8. おすすめの使い方(ベストな使い方の提案)
現時点で最もバランスが良いのは、OpenAIgpt56Solを土台に、Anthropicの「近似と厳密計算の区別」「JIS附表への注意」を加え、XAIの簡潔な境界説明で補強する使い方です。
- 計算結果と最小性の説明:OpenAI
- 簡潔な境界確認:XAI
- 規格表・丸めへの注意:Anthropic
- 外部資料の探索:Perplexityのリンクのみ限定利用
- Plamoの55:規格表由来であることが確認できた場合に限り候補化
特定の1回答を直接採用するならOpenAIが最も完成度が高いですが、正式文書に転用する際は、
を「良いロットの基準不適合品率」と明記し、二項分布による最小解であることと、JIS附表による正式採用値の確認が別途必要であることを追記するのが適切です。
よくある質問
Q1.ChatGPTだけで抜取検査のサンプル数を決めてもよいですか?
おすすめしません。
ChatGPTは候補を求めたり、計算を支援したりする用途には非常に便利ですが、品質保証の最終判定には正式な規格や顧客要求、社内基準との照合が必要です。
特に出荷判定や受入判定に直接使用する場合は、AI回答だけで決定しないことが重要です。
Q2.ChatGPTとGeminiで違う回答が出た場合、どちらを信用すればよいですか?
AIの名前ではなく、計算結果を確認します。
例えば、
・p0での合格確率
・p1での合格確率
を再計算し、α、βの条件を満たしているか確認します。
複数のAIが同じ答えを出しても、必ずしも正しいとは限りません。
逆に、異なる答えでも両方が条件を満たしている場合があります。
重要なのは、
「AI同士を多数決することではなく、統計計算で検証すること」
です。
Q3.サンプル数は多いほど安全ですか?
必ずしもそうではありません。
同じ合格判定個数cのままnだけ増やすと、悪いロットを合格させる消費者危険は小さくなる場合があります。
一方で、良いロットの中にも一定数の不良品が含まれるため、サンプル数を増やすことで良いロットを不合格にする生産者危険が増える場合があります。
したがって、
「nが大きい=常に安全」
とはいえません。
nとcをセットで評価することが重要です。
Q4.ロットサイズは計算に入れなくてもよいですか?
ロットに対してサンプル数が十分小さい場合は、二項分布で近似することがあります。
しかし、サンプル数がロットサイズに対して大きい場合は、有限母集団から非復元抽出するため、超幾何分布を検討する必要があります。
したがって、ロットサイズが小さい場合には、
「二項分布でよいか」
も確認する必要があります。
Q5.AIにOC曲線を作らせることはできますか?
可能です。
nとcが決まれば、不良率pを変化させながら合格確率を計算することでOC曲線を作成できます。
ChatGPTに、
「不良率0%~20%まで1%刻みで合格確率を計算してください」
と指示すれば、OC曲線用のデータを作成できます。
さらに、Excel用の表やグラフ作成方法を生成させることもできます。
Q6.AIで抜取検査を使う最大のメリットは何ですか?
大きなメリットは、
「計算そのものよりも、複数条件の比較が短時間でできること」
です。
例えば、
n=54、c=3
n=60、c=3
n=65、c=3
など複数案について、
・生産者危険
・消費者危険
・検査工数
・検査費用
を比較できます。
これにより、品質とコストのバランスを検討しやすくなります。
Q7.重大な安全不良にも抜取検査を使えますか?
製品安全や人命に関係する重大不良については、通常の抜取検査だけで品質保証することが適切とは限りません。
不良流出時のリスクが非常に大きい場合には、
・全数検査
・ポカヨケ
・工程能力向上
・自動検査
・発生防止対策
などを組み合わせる必要があります。
抜取検査は、不良を作らない仕組みの代わりではありません。
まとめ
ChatGPTなどの生成AIを活用すると、計数規準型抜取検査のサンプル数nや合格判定個数cの候補を短時間で求めることができます。
特に、
・二項分布による計算
・最小サンプル数の探索
・生産者危険の確認
・消費者危険の確認
・OC曲線用データの作成
・複数の抜取方式の比較
などでは、AIは非常に有効な支援ツールです。
しかし、品質管理の実務で重要なのは、AIが出した答えそのものではありません。
重要なのは、次の流れです。
- 条件を正しく設定する
- AIに計算させる
- 計算結果を再確認する
- JIS規格と照合する
- 顧客要求・社内基準を確認する
- 現場条件を加えて最終判断する
生成AIを利用するときは、
「AIに品質判定を任せる」のではなく、「品質管理技術者の判断をAIに支援させる」
という考え方が重要です。
AIは計算を速くしてくれますが、p0、p1、α、βをどのように設定するか、そして最終的にその検査方式を採用するかどうかは、人が判断しなければなりません。
これからの品質管理では、
「JIS・統計的品質管理の知識+AIによる計算支援+人による検証」
を組み合わせることが、安全で効率的なAI活用につながります。
最後に【2026年版】AI・ChatGPTでAQL指標型抜取検査のサンプル数を決める方法は下記を参照願いします。
コメント